Gemini 4 Argon 已向 API 开发者和 Pro/Ultra 用户开放,AI Studio 同步可调用。对大多数人来说,这是一次日常更新,去 AI Studio 试一下就知道能用什么。但这次发布配套展示的几个演示里,有一件具体的事值得说清楚,因为它涉及生成视频里一个长期没解决的基础问题。

生成的世界为什么总记不住你动过的东西
用视频生成模型做交互场景有一个根本缺陷:你在场景里移动一个物体,镜头一转,它就不在你放的地方了。模型重新生成画面时,并不知道那个杯子被你推到了桌角,也不知道门之前被打开过。每一帧都像是对场景的重新猜测,而不是对状态的延续。
这让”可交互的生成世界”在演示以外很难落地,因为一旦场景需要多步操作,前后状态的一致性几乎无法保证。
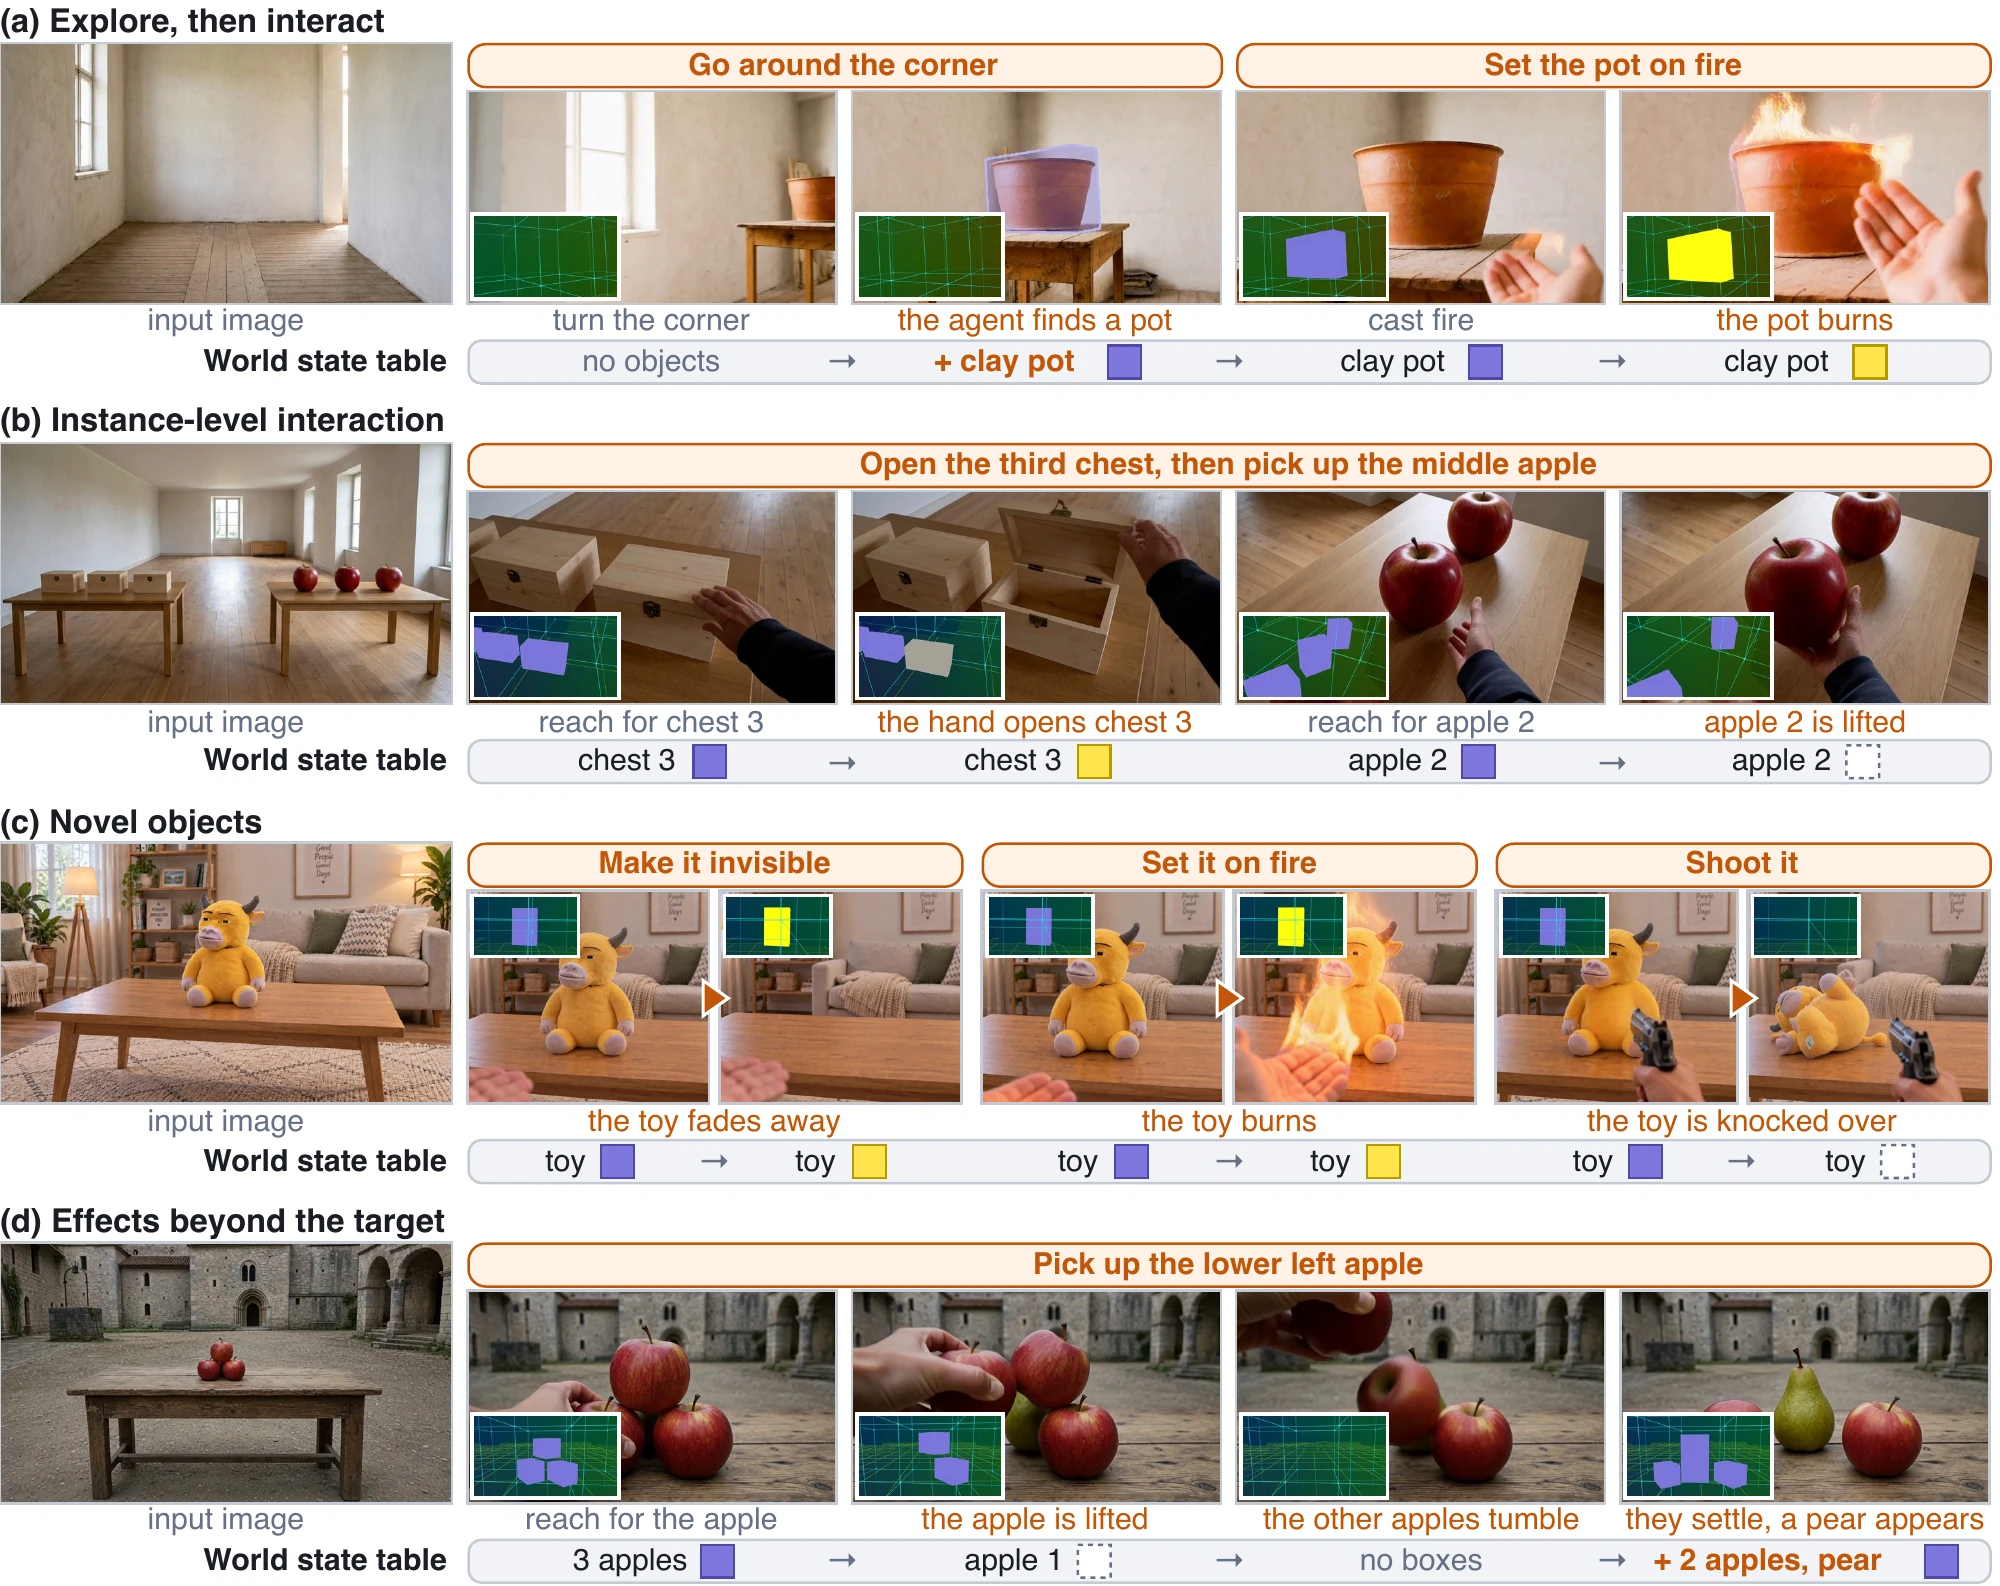
Oneira 项目提出的解法方向是把这两件事分开处理。它用一个 Coding Agent 专门维护一张世界状态表,记录哪些物体在场景里、它们的当前位置和已发生的变化,新出现的物体也能加入这张表。视频模型只负责根据这张表把画面补全,不再负责”记忆”。
这个分工有一定道理。语言和代码模型本身就擅长维护结构化状态,让它做台账,比让视频模型隐式地记住几十帧之前发生过什么,在技术上更容易控制。项目来自牛津、莫纳什等高校团队,演示页面展示了指定物体交互和多步操作的效果,做世界模型方向的开发者可以直接去对照看。
Gemini 4 Argon 在这里扮演什么角色
Google 同时展示了 Gemini 4 Argon 用于机器人训练仿真的演示:给模型一段人类玩投沙包游戏的视频,它自动分析动作并帮助生成训练环境,机器人再在仿真里练习。这件事的重点不是”模型看一眼就会”,而是减少手动编写仿真场景的工作量。
还有一个多智能体 Blender 建模的展示,协调智能体统筹,批评智能体逐帧检查渲染结果,多个智能体分工建模。演示者说”一条提示词盖了座日本寺庙”,但那条提示词背后实际上是一套完整的工程流程,只是包装成了一行字。这类演示容易被简化成”一句话生成”的标题,值得注意的是实际的系统复杂度。
这三个场景放在一起看,Gemini 4 Argon 被反复用于的位置是:理解一段复杂输入(视频、多步操作记录),然后生成或协调后续任务。这不是单纯的文本问答,也不是独立的图像生成,而是在一个更长的工作流里承担理解和调度的那一环。
对开发者的判断
如果你在做世界模型、交互视频或机器人训练仿真方向,Oneira 的状态表思路值得关注,不一定要直接用它的实现,但那个”把状态管理和画面生成分开”的架构分工是值得参考的设计原则。演示页面有实际效果可以看,项目地址是 madaoer.github.io/projects/oneira。
Gemini 4 Argon 本身现在可以通过 AI Studio 直接调用,已经有 Pro 或 Ultra 账号的开发者不需要额外申请权限。建议先用自己实际在做的任务去跑几个场景,而不是复现演示视频里的效果,因为演示场景的成本和工程量通常不在展示范围内。

参考资料
完整版日报请看 爱窝啦 AI 日报