Grok bot 最近宣布的一项变化值得仔细看:它不再只调用 xAI 自己的模型,而是根据任务类型自动选用外部 API,包括 Claude Opus 5.5、Midjourney、Suno 等。这在表述上听起来像一次服务升级,但实际的使用边界比宣传更窄。

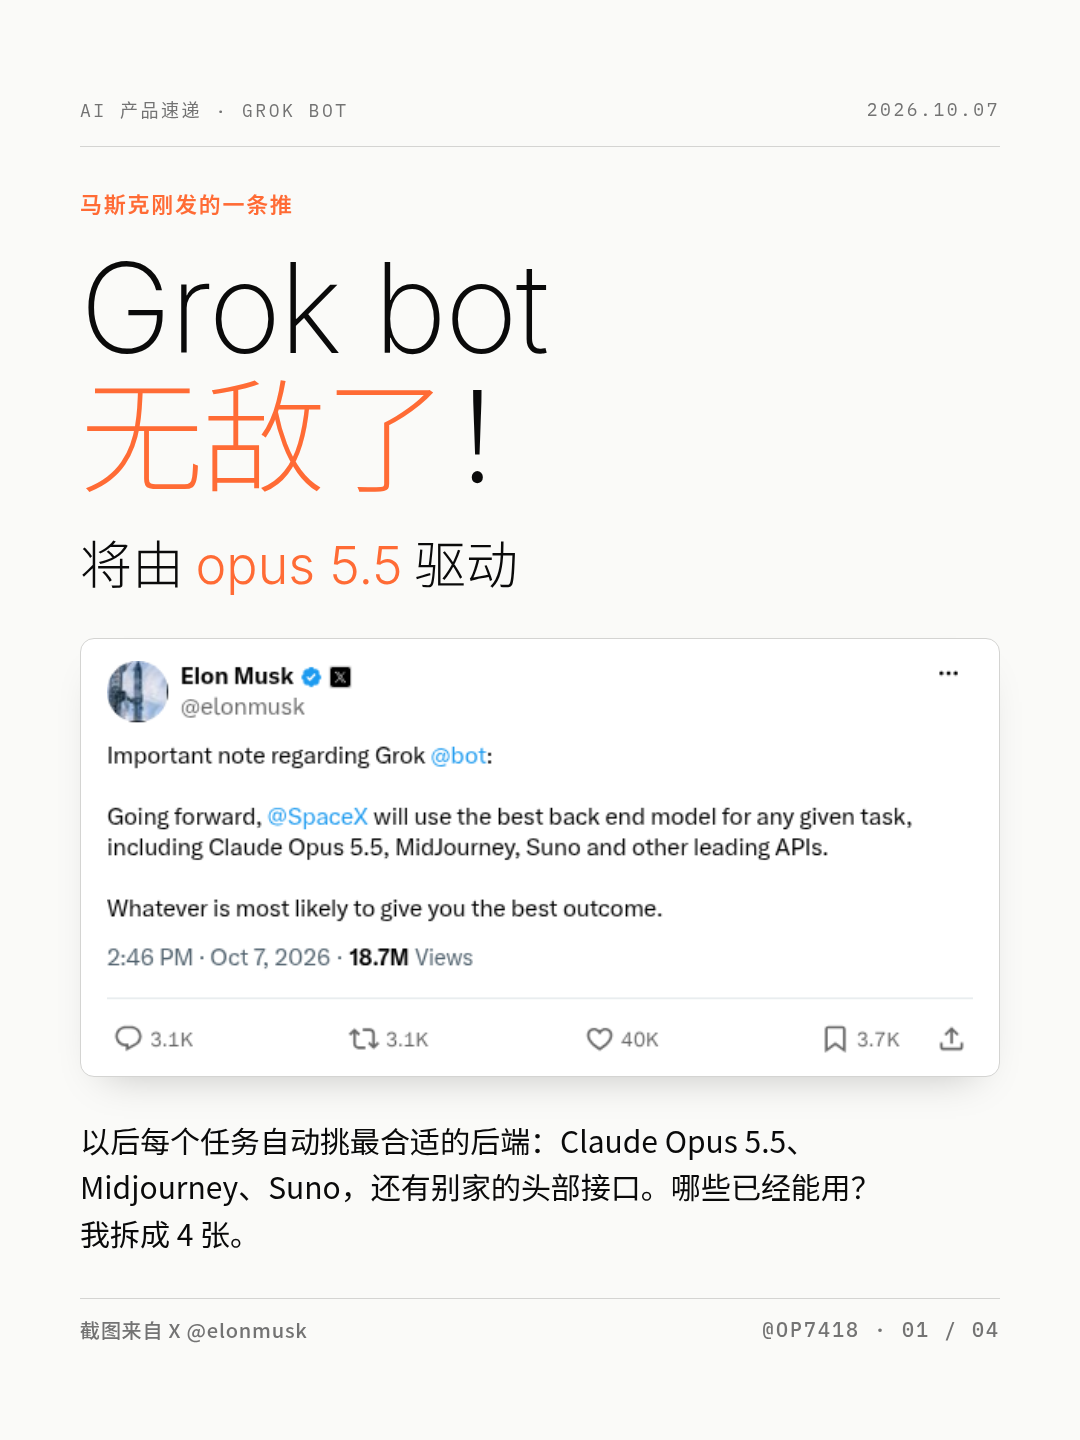
目前部分任务已由 Opus 5.5 驱动,Midjourney 和 Suno 的能力尚未上线。用户无法手动指定模型,由系统自动分配。这意味着你用 Grok 发出一个请求,底层跑的可能是另一家公司的模型,你既不知道是哪个,也没有办法主动选择。
这种设计逻辑不新鲜。路由多个底层模型、对用户屏蔽细节,是智能体平台的常见做法。但它对实际使用带来几个值得注意的地方。
你无法稳定复现某个模型的行为。 如果你今天用 Grok 做了一段文案,觉得效果不错,明天同样的提示词可能走向另一个模型,结果不一样。对于需要输出风格一致的任务,这种不透明度是个真实的代价。
隐私边界变模糊了。 你的请求内容在 Grok 的路由决策之后,可能进入 Anthropic 或 Midjourney 的处理链路。xAI、Anthropic 各自的数据使用政策是否互相兼容,目前用户没有简单的方式核验。对于有数据合规要求的使用场景,这需要格外谨慎。
这也是为什么腾讯开源的 Octop 会同时出现在今天的讨论里。Octop 的设计方向几乎是 Grok bot 的反面:多智能体协作、命令行与浏览器自动化的能力组合,但对话记录和知识库完全保存在本地设备。它能接入微信、飞书、钉钉等聊天软件,适合需要自动化但对数据外流有顾虑的场景。
两者都在做”让用户通过一个入口调用多种 AI 能力”这件事,但出发点不同。Grok 走的是订阅平台集成路线,Octop 走的是私有部署路线。选哪个取决于你的核心约束是什么:如果主要关心功能便利性,Grok 的接入方式更低摩擦;如果数据必须不出本地,Octop 的方向更契合需求,但也意味着你要自己维护部署环境。
我的判断是,Grok 接入外部模型这件事本身并不特别值得兴奋,它更像是一个平台在模型竞争格局不稳定时期的对冲动作。对用户来说,真正需要确认的不是”接入了哪些模型”,而是”我的请求到底经过了哪些系统,这些系统各自的数据处理政策是什么”。这个问题目前 Grok 的产品页面并没有给出清晰答案。
如果你现在在评估是否用 Grok 处理包含敏感信息的任务,我建议先看一下 xAI 与各合作方的数据处理条款,再决定。
参考资料
完整版日报请看 爱窝啦 AI 日报